En aplicaciones corporativas que manejan miles de transacciones diarias, enterarse de que el sistema tiene un error porque un cliente furioso llamó a soporte técnico es el peor escenario operativo posible. La mayoría de los fallos graves de software —consultas SQL lentas, APIs de terceros fuera de servicio o fugas de memoria— no ocurren de forma repentina; dan señales progresivas que solo son visibles si se cuenta con una infraestructura de Observabilidad y APM (Application Performance Monitoring).
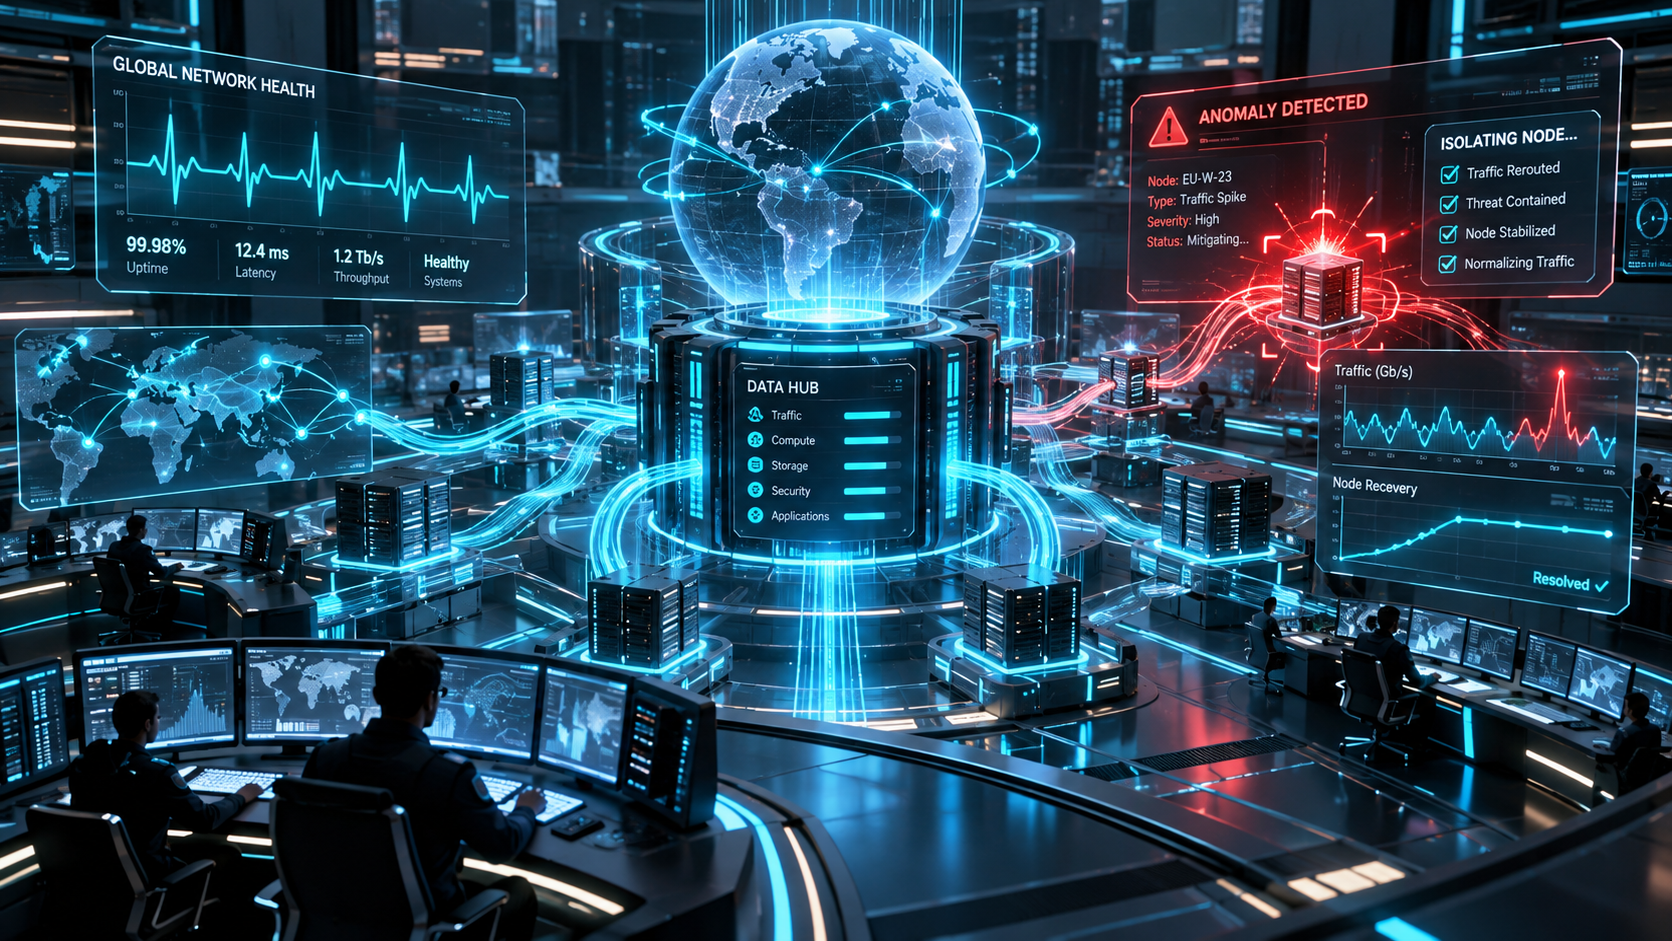
La observabilidad no es simplemente guardar logs en un archivo de texto; es la capacidad de inferir el estado interno de un sistema analizando las métricas, trazas y eventos que genera en tiempo real.
1. Los Tres Pilares de la Observabilidad
- Logs Estructurados: Registros detallados de eventos contextualizados en formato JSON, etiquetados por usuario, IP y tipo de acción para facilitar su filtrado instantáneo.
- Métricas en Tiempo Real: Indicadores cuantitativos del rendimiento de la infraestructura: consumo de CPU, uso de RAM, tasa de peticiones por segundo y tiempo de respuesta del servidor (TTFB).
- Trazado Distribuido (Distributed Tracing): La capacidad de seguir el recorrido exacto de una petición HTTP desde que entra al servidor, pasa por los middlewares de Laravel, ejecuta consultas SQL y consulta una API externa, midiendo cuántos milisegundos consumió cada paso.
2. Herramientas APM esenciales para el ecosistema Laravel
- Laravel Pulse & Telescope: Soluciones nativas para entornos de desarrollo y producción que permiten auditar trabajos en cola (Queues), consultas SQL pesadas, eventos y peticiones lentas directamente desde el ecosistema del framework.
- Sentry / Bugsnag: Plataformas de rastreo de excepciones que capturan el contexto exacto del error (incluyendo variables de sesión y traza de pila de código) en el instante preciso en que le ocurre a un usuario en producción, notificando al equipo por Slack o Teams.
- Datadog / New Relic: Soluciones de monitoreo de infraestructura profunda que alertan sobre picos anómalos en la latencia de la base de datos o saturación de procesos PHP-FPM.
3. El Impacto Operativo del Monitoreo Proactivo
Implementar una estrategia de APM permite pasar de un modelo de soporte reactivo (apagar incendios cuando el daño ya está hecho) a un modelo proactivo: resolver un cuello de botella en la base de datos o parchear un error de código minutos después de que ocurra por primera vez, garantizando una disponibilidad del 99.9% (High Availability).
Protegé la continuidad operativa de tus activos digitales. En Craw Digital diseñamos e implementamos arquitecturas con observabilidad de grado corporativo.